



Hace poco más de un año, el Proyecto oriGen celebró la incorporación de su participante número 100,000 y el cierre del trabajo de campo. El 8 de octubre, durante el oriGen Data Forum, el proyecto anunció su siguiente hito: el 100% de las muestras de oriGen está secuenciado, con un total de 100,000 exomas, la parte del ADN que contiene las instrucciones para fabricar proteínas.
Con ello, la información genómica, clínica y epidemiológica de la cohorte —el grupo de 100,000 participantes de quienes se obtuvieron muestras y datos de salud— queda disponible para proyectos de investigación, bajo una nueva política de acceso.
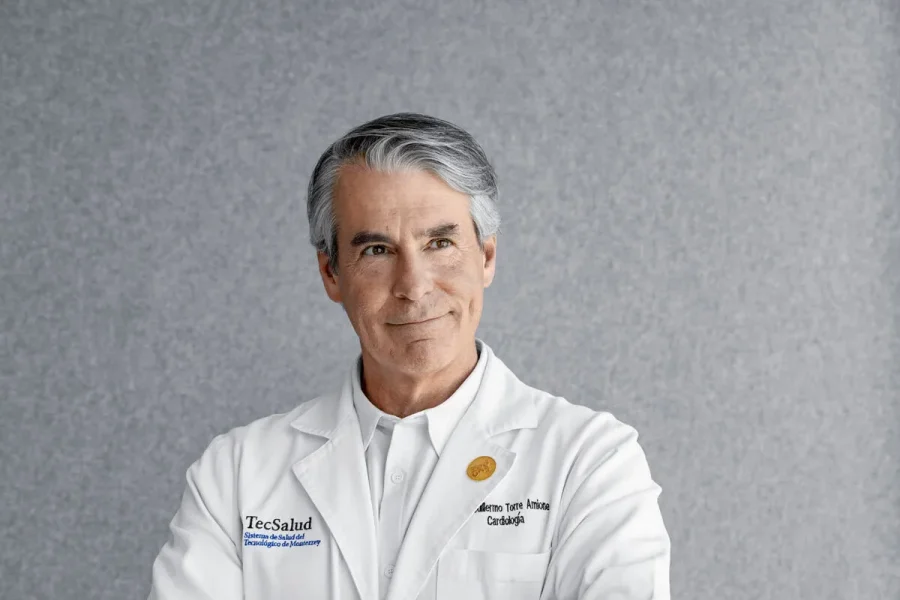
“Pasamos de generar datos a convertirlos en conocimiento”, resumió en el foro Guillermo Torre, rector de TecSalud.
Para diciembre se espera contar con 10,000 genomas completos que, según el director general del proyecto, Pablo Kuri, conformarán la base de datos más completa de su tipo en América Latina.
La secuenciación se realizó con Regeneron Genetics Center, que participó a cambio de acceso a los datos. El proyecto resguarda, además, unos 500,000 tubos con ADN, plasma y sangre.
Los primeros resultados del proyecto ya están publicados. En 1,427 genomas completos de participantes reclutados en la zona metropolitana de Monterrey, el equipo encontró cerca de 100,000 variantes de una sola letra del ADN —y casi tres millones de variantes en total— que no aparecían en las principales bases de referencia, incluida la del Mexico City Prospective Study, un estudio de la UNAM y la Universidad de Oxford que desde finales de la década de 1990 da seguimiento a la salud de más de 150,000 habitantes de la Ciudad de México. El estudio de oriGen se publicó el 5 de septiembre en la revista Nature Communications.
“Nos quisimos concentrar en capturar la mayor diversidad genética del país”, explicó el director científico del proyecto, Víctor Treviño. Para la cohorte completa, recorrieron 19 estados, recopilando datos de una o dos personas por vivienda y evitando reclutar a familiares. El resultado se observa en los 1,427 genomas analizados: solo el 17% de los participantes tenía algún pariente, incluso lejano, dentro del grupo, mientras que en el Mexico City Prospective Study esa proporción alcanza el 71%.
La prevalencia de diabetes en diferentes edades
¿A qué edades es más común la diabetes en México? Para responder, el equipo de Jaime Berumen comparó dos cohortes: los participantes de oriGen mayores de 35 años y los del Mexico City Prospective Study. El corte de edad se debe a que este último solo reclutó a personas de 35 años o más, así que los grupos tenían que ser comparables.
Contando los casos diagnosticados y los que no lo estaban (personas con diabetes sin saberlo), esta enfermedad alcanzó casi el 24% en oriGen y el 19% en el Mexico City Prospective Study.
La brecha entre ambos estudios fue todavía mayor en la prediabetes, es decir, cuando los niveles de azúcar en sangre están por encima de lo normal, pero aún no alcanzan el umbral de la diabetes. Entre los adultos más jóvenes, cerca del 20% de los participantes de oriGen tenía prediabetes, frente al 10% en el Mexico City Prospective Study. Parte de esa diferencia podría deberse a que ambas cohortes se reclutaron con unos 25 años de distancia y con métodos de medición distintos.
El análisis por edad también mostró patrones distintos. Según Berumen, la prediabetes y la diabetes no diagnosticada aumentan hasta alrededor de los 50 o 55 años y luego se estabilizan. La diabetes diagnosticada, en cambio, sigue creciendo con la edad, porque los casos se van acumulando.
La obesidad también pesa distinto según la edad. Antes de los 52 años, las personas con obesidad tuvieron una probabilidad 4.5 veces mayor de tener diabetes no diagnosticada; después de esa edad, la probabilidad fue cerca de tres veces mayor. Berumen adelantó que este mes enviará estos resultados a la revista The Lancet Diabetes & Endocrinology.
Un modelo de envejecimiento mexicano
La primera cohorte de oriGen incluye a personas de entre 18 y 108 años, con casi 32,000 mayores de 60 (13,492 hombres y 18,288 mujeres). Para Rocío Ortiz López, líder de laboratorio y repositorio del proyecto, esta base permite estudiar el envejecimiento en México, donde, dijo, no hay modelos de fragilidad validados para su población; los existentes se construyeron con poblaciones europeas y estadounidenses.
La investigadora destacó que a menudo se evalúa a los pacientes de la misma manera, sin importar si son mujeres u hombres, aunque sus trayectorias de salud pueden ser muy distintas.
Por eso, para construir el modelo de envejecimiento del país, el equipo analizó a mujeres y hombres por separado: ambos envejecen de forma metabólica distinta y los factores que más influyen en su deterioro tampoco son los mismos. En los hombres, por ejemplo, pesa más el consumo de alcohol; en las mujeres, el número de partos.
En el caso de los hombres, 1,816 informaron consumir alcohol y alrededor del 5% de ellos portaba variantes genéticas que podrían afectar la forma en que el organismo procesa este alcohol.
Las personas de mayor edad, con niveles más altos de azúcar en sangre o con diabetes tendían a tener menos copias de ADN mitocondrial. Se trata de resultados preliminares que aún están por confirmarse.
Inteligencia Artificial para estimar la grasa visceral y el riesgo metabólico
El oriGen Health Research Center, creado por el Tec y la Universidad de Texas en Austin, comenzó a operar en marzo de 2025. Su primer protocolo busca un modelo de inteligencia artificial que estime la grasa visceral a partir de datos de medidas corporales y variables genéticas, sin recurrir a métodos como la resonancia magnética, que son costosos y poco accesibles.
En una prueba piloto con 41,466 participantes de oriGen, el análisis del índice de masa corporal identificó 120 variantes en nueve regiones del genoma. La heredabilidad estimada fue de 24.5%; es decir, la genética explicaría aproximadamente una cuarta parte de las diferencias en el índice de masa corporal en este grupo.
“No es que la genética decida el peso de alguien, sino que es una de las piezas del rompecabezas”, explicó el codirector del centro, Alexandro Martagón. Ya se seleccionaron tres proyectos nuevos: una “biopsia digital” metabólica, un estudio de resiliencia cognitiva y otro sobre riesgo genético en cáncer de mama, colorrectal y gástrico.
Emanuel Martínez Ledesma, del Institute for Obesity Research del Tec, también presentó los resultados preliminares de su proyecto. Su punto de partida fue que el índice de masa corporal no refleja el estado metabólico en cerca del 30% de las personas.
Con las respuestas del cuestionario de oriGen y datos de química sanguínea, su equipo entrenó un modelo que predice el índice de masa corporal y revisa en quiénes se equivoca. Los errores fueron más frecuentes entre quienes cumplían tres o más criterios de síndrome metabólico.
En un segundo análisis, al cruzar 12 enfermedades cardiometabólicas con 49 variables de nutrición y estilo de vida, el equipo encontró asociaciones, no relaciones de causa. Cocinar con aceite más de cinco días a la semana se asoció con colesterol y triglicéridos altos; dormir más de seis horas, con menor probabilidad de obesidad; y haber fumado más de 100 cigarrillos, en mujeres, con infarto. La meta es una biblioteca de modelos con la que una persona pueda estimar su riesgo con preguntas o con estudios que ya tenga.
Cómo se pide acceso a los datos
Durante un embargo de dos años, los datos quedan reservados para investigadores mexicanos o para quienes trabajen en instituciones con convenio con el Tec, como la Universidad de Texas en Austin. Después, según el paper, se abrirán a la comunidad científica internacional.
Para los que quieran acceder al repositorio de datos, las solicitudes pasan por una revisión documental de hasta cuatro semanas. Después las evalúa un comité científico de cinco integrantes, presidido por Treviño. Se puede pedir uno de tres niveles: información clínica y epidemiológica; esa información más genotipos; o exomas y genomas. Los investigadores deben entregar informes anuales y devolver los datos que generen.
Para Javier Guzmán, vicepresidente de Investigación del Tec, el impacto de oriGen no se medirá por el número de muestras, sino por las investigaciones y colaboraciones que surjan y por las preguntas que se logren responder. “Ahora, el siguiente capítulo está en manos de ustedes”, dijo Guzmán.
¿Te interesó esta historia? ¿Quieres publicarla? Contacta a nuestra editora de contenido para más información: marianaleonm@tec.mx